Zarządzanie infrastrukturą AI dla centrów danych AI i fabryk AI
Zarządzanie infrastrukturą AI w jednej platformie on-premises: AI Cockpit odpowiada na pytanie zadane w języku naturalnym dedykowanym pulpitem i 30-sekundowym wideo z danymi, tworzonymi na podstawie tej samej inwentaryzacji, na której działają Państwa pule GPU, zadania, monitoring obiektu i pomiary.
Sensaka for AI Data Centers łączy infrastrukturę AI, heterogeniczne zasoby obliczeniowe, klastry GPU, obciążenia związane z trenowaniem i wnioskowaniem, sieci, pamięć masową, systemy chłodzenia cieczą i procesy operacyjne w jednej platformie. Przekształca rozproszone zasoby obliczeniowe w możliwości biznesowe, które można monitorować, szeregować, mierzyć i nieustannie optymalizować.
Od systemów chłodzenia cieczą, serwerów i kart akceleratorów w centrum danych, przez pule zasobów, szeregowanie obciążeń, alarmy, zgłoszenia serwisowe, CMDB, pomiar kosztów, aż po analitykę operacyjną — platforma buduje ujednoliconą pętlę operacyjną opartą na wspólnej podstawie danych.
Od dostarczenia infrastruktury do ciągłych operacji
Po zbudowaniu centrum danych AI priorytety zarządzania przesuwają się od dostarczenia infrastruktury i liczby sprzętu w stronę wykorzystania zasobów obliczeniowych, wskaźników powodzenia obciążeń, jakości usług, kosztów operacyjnych i efektów biznesowych.
Tradycyjne platformy monitoringu zwykle potrafią wskazać, czy urządzenie jest online. Nie potrafią jednak łatwo wyjaśnić, czy zasoby obliczeniowe są wykorzystywane efektywnie, dlaczego zadania treningowe oczekują, czy niskie wykorzystanie GPU wynika z wąskich gardeł w zasobach obliczeniowych, sieci czy pamięci masowej, ani które obciążenia i usługi biznesowe zostaną dotknięte awarią sprzętu.
Sensaka for AI Data Centers łączy pięć wymiarów operacyjnych: ludzi, infrastrukturę fizyczną, działania, zasoby obliczeniowe i usługi biznesowe.
Łączy status infrastruktury, zasoby obliczeniowe, relacje obciążeń, dostarczanie usług, odpowiedzialność pracowników i procesy operacyjne w jednym, ujednoliconym środowisku zarządzania, pomagając organizacjom przejść od modelu dostarczania infrastruktury do ciągłych operacji centrum danych AI.
Pytanie, a w odpowiedzi pulpit i 30-sekundowe wideo z danymi
Stałe pulpity odpowiadają na pytania, które ktoś wcześniej przewidział. AI Cockpit odpowiada na pytanie zadane dzisiaj. Po wpisaniu pytania w języku naturalnym platforma tworzy dla niego pulpit z danych, które już posiada, a następnie przekształca go w krótkie wideo, gdy pulpit jest zbyt gęsty, by go omówić.
Pytanie
Wpisanie pytania lub słów kluczowych, na przykład które GPU są bezczynne lub którzy dzierżawcy zbliżają się do limitu.
Dopasowanie
Pytanie jest dopasowywane lokalnie do predefiniowanych pytań operacyjnych, z których każde ma własne źródło danych, regułę, próg i sugerowane działanie.
Pulpit
Dla tego pytania tworzony jest dedykowany pulpit: najważniejsze pozycje, zestawienia i porównania, każde z możliwością przejścia do rekordów źródłowych.
Wideo
Jedno kliknięcie zamienia pulpit w 30-sekundowe wideo z danymi generowane w przeglądarce, gotowe na spotkanie zarządu.
Działa on-premises. Pytania są dopasowywane lokalnie, żaden zewnętrzny model językowy nie jest wywoływany, a dane operacyjne pozostają w Państwa centrum danych.
Wideo jest rysowane i kodowane w przeglądarce z napisami opartymi na liczbach z pulpitu, dzięki czemu przekazuje dokładnie to, co pokazuje pulpit.
Zbieranie danych, dane, usługi i kokpit na jednym zbiorze danych
Platforma ma budowę warstwową. Warstwa zbierania odczytuje fizyczne środowisko in-band i out-of-band. Jedna podstawa danych przechowuje powiązania CMDB, szeregi czasowe, zdarzenia i rekordy wykorzystania. Usługi dla pul, zadań, pomiaru zużycia, alertów, zgłoszeń i procesów działają na tych danych, a kokpity znajdują się na samej górze. Interfejsy integracyjne łączą każdą warstwę z chmurami i narzędziami, z których Państwo już korzystają.
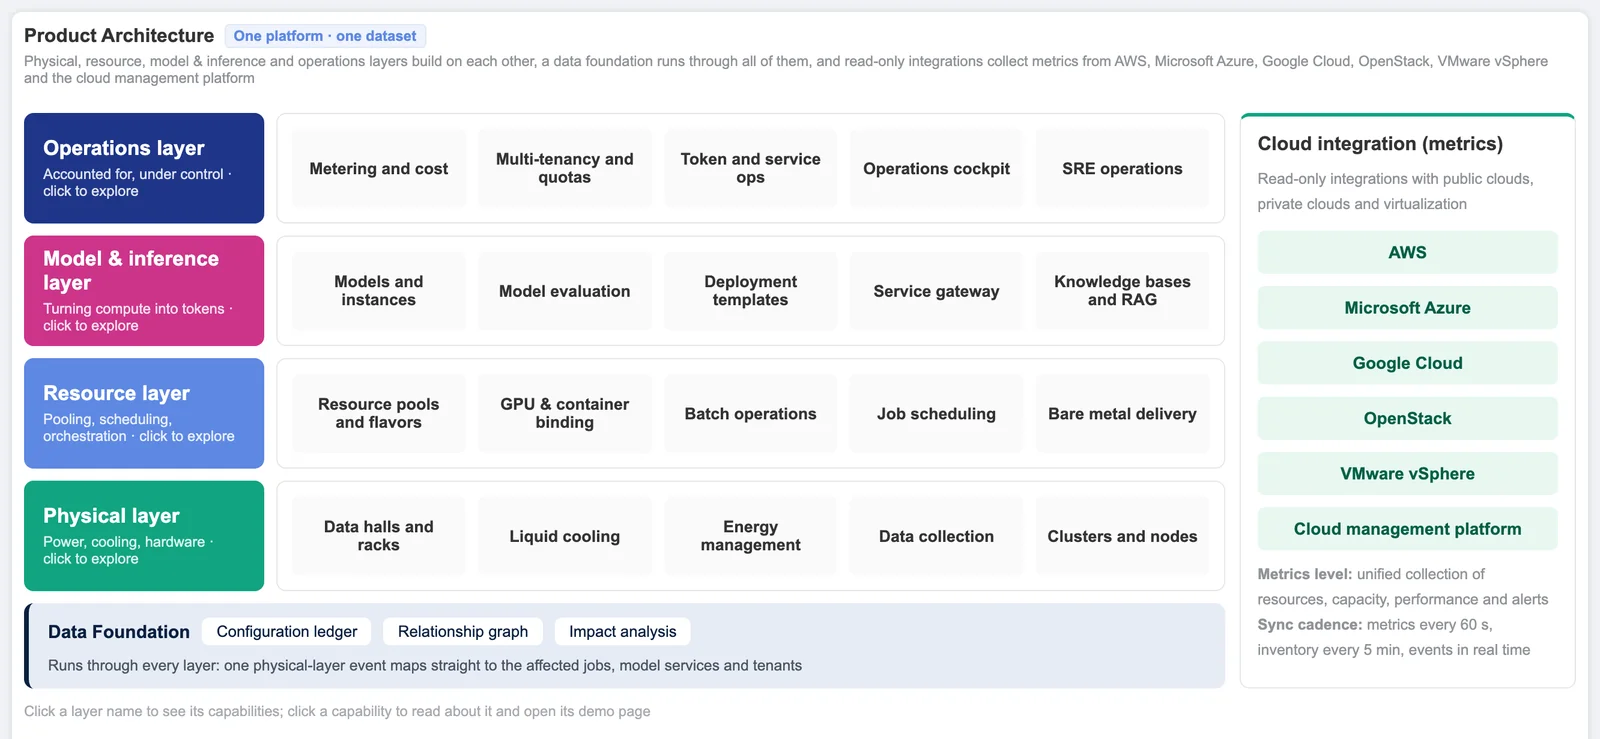
Ta sama platforma obsługuje korporacyjne centra danych AI, fabryki AI sprzedające dzierżawcom pojemność GPU lub tokeny oraz klastry badawcze współdzielone przez różne działy. Jest wdrażana on-premises i działa bez połączenia z internetem.
Jedna platforma dla ujednoliconego zarządzania centrum danych AI
Ujednolicony monitoring
Centralizacja statusu, wydajności, pojemności i alarmów serwerów, kart akceleratorów, sieci, systemów pamięci masowej, szaf rack, systemów zasilania, sprzętu do chłodzenia cieczą i infrastruktury środowiskowej.
Ujednolicone zarządzanie
Wykorzystanie CMDB infrastruktury AI do budowania relacji w czasie rzeczywistym między centrami danych, urządzeniami, kartami akceleratorów, klastrami, obciążeniami, projektami, zespołami i usługami biznesowymi.
Ujednolicone szeregowanie
Przekształcanie rozproszonych fizycznych zasobów obliczeniowych w ustandaryzowane pule zasobów, które można rezerwować, przydzielać, zwalniać i nadzorować.
Ujednolicony pomiar zużycia
Pomiar godzin pracy akceleratorów, zużycia zasobów, zużycia energii i danych operacyjnych w podziale na projekt, dzierżawcę i typ zasobu.
Ujednolicone operacje
Połączenie monitoringu, analizy, diagnostyki, alarmów, zgłoszeń serwisowych, zatwierdzeń i działań związanych z szeregowaniem zadań w jeden kompletny proces operacyjny.
Zarządzanie zasobami GPU i NPU wielu producentów w jednej platformie
Centra danych AI często zawierają sprzęt akceleracyjny różnych producentów, modeli i architektur. Sensaka zapewnia ujednolicone zarządzanie heterogenicznymi zasobami obliczeniowymi w takich środowiskach.
Platforma identyfikuje typy akceleratorów w każdym węźle, gromadzi GPU i NPU różnych producentów we wspólnej inwentaryzacji oraz buduje relacje między modelem akceleratora, jego liczbą, węzłem fizycznym, statusem operacyjnym i przydziałem zasobów.
Podstawowe funkcje
- Automatyczna identyfikacja GPU i NPU wielu producentów
- Inwentaryzacja kart akceleratorów na poziomie komponentów
- Ujednolicone zarządzanie w wielu regionach i klastrach
- Monitoring wykorzystania, temperatury, zasilania i kondycji na poziomie karty
- Wykrywanie nieprawidłowości akceleratorów i rekomendacje izolacji
- Akceleratory NVIDIA, AMD i inne w jednej inwentaryzacji
Wartość biznesowa
Ograniczenie zależności od osobnych narzędzi producentów i zarządzanie heterogenicznymi zasobami obliczeniowymi za pomocą jednego spójnego interfejsu.
Tworzy to wiarygodną podstawę danych do szeregowania zadań, planowania pojemności, zarządzania infrastrukturą i podejmowania decyzji operacyjnych.
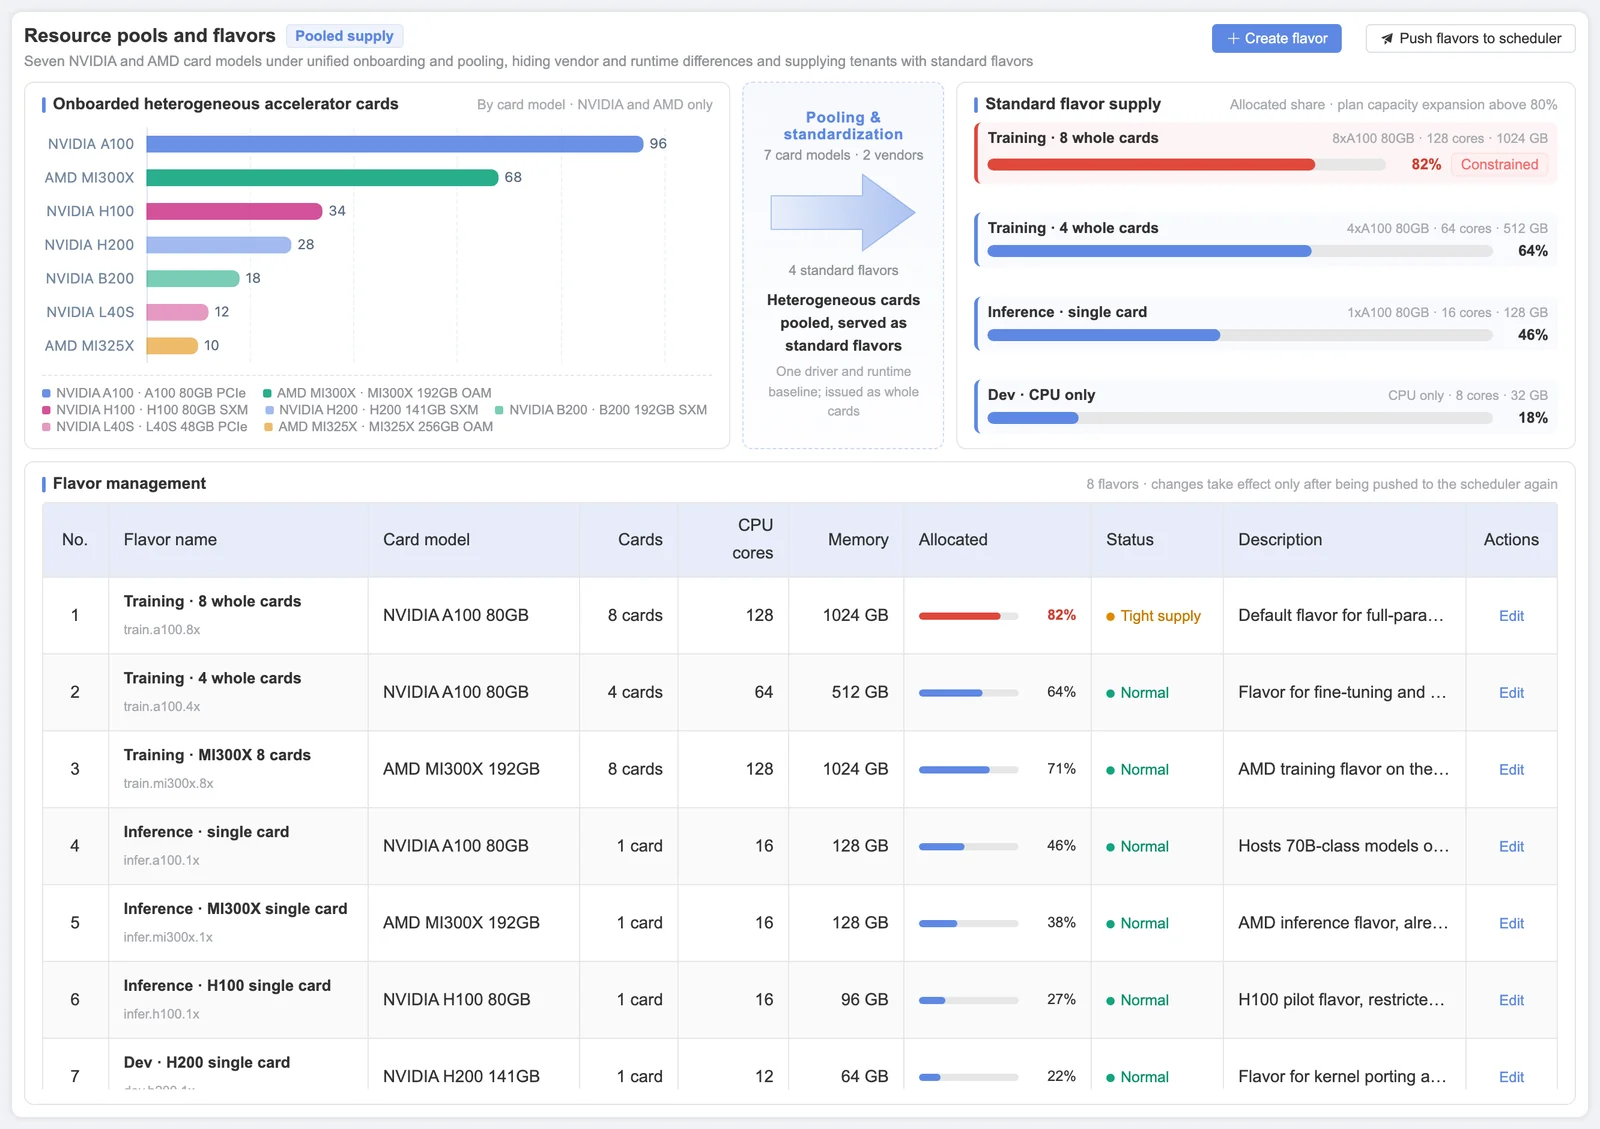
Przekształcanie sprzętu GPU w zasoby obliczeniowe gotowe do przydziału
Sensaka przekształca fizyczne karty akceleratorów w pule zasobów i zarządza obciążeniami związanymi z trenowaniem, wnioskowaniem i pracami programistycznymi za pomocą ustandaryzowanych specyfikacji, limitów dla dzierżawców, kolejek obciążeń i polityk szeregowania.
Platforma udostępnia pojemność w postaci standardowych specyfikacji, stosuje limity dla dzierżawców wyrażone w godzinach GPU, tokenach i pamięci masowej, kolejkuje żądania według priorytetu z wywłaszczaniem i automatycznie zwalnia zasoby, gdy obciążenie się zakończy lub przekroczy limit czasu. Funkcje te pomagają centrom danych AI i fabrykom AI ograniczać fragmentację, bezczynne zasoby i nieefektywny przydział.
Nowe serwery trafiają do puli dzięki zautomatyzowanemu przygotowaniu bare-metal: konfiguracji BMC, instalacji systemu operacyjnego przez PXE, sterownikom i środowisku uruchomieniowemu oraz bramce testu obciążeniowego (burn-in), która nie dopuszcza wadliwego sprzętu.
Podstawowe funkcje
- Łączenie heterogenicznych zasobów obliczeniowych w pule
- Specyfikacje zasobów dla trenowania, wnioskowania i prac programistycznych
- Klasyfikacja obciążeń związanych z trenowaniem i wnioskowaniem
- Zarządzanie kolejkami obciążeń
- Kontrola limitów dla projektów i dzierżawców
- Przydział według standardowej specyfikacji w ramach limitów dzierżawców
- Strategie priorytetów, wagi zasobów i zapełniania węzłów
- Automatyczne zwalnianie zasobów po zakończeniu lub przekroczeniu limitu czasu
- Izolacja wadliwych węzłów po potwierdzeniu przez operatora
- Wykrywanie bezczynnych GPU według ustalonego przez Państwa progu wykorzystania
- Przygotowanie bare-metal z bramką testu burn-in, zanim serwer dołączy do puli
Wartość biznesowa
Zwiększenie wykorzystania GPU, ograniczenie nadmiernego przydziału i przestojów oraz priorytetyzacja zasobów obliczeniowych dla obciążeń o najwyższej wartości biznesowej.
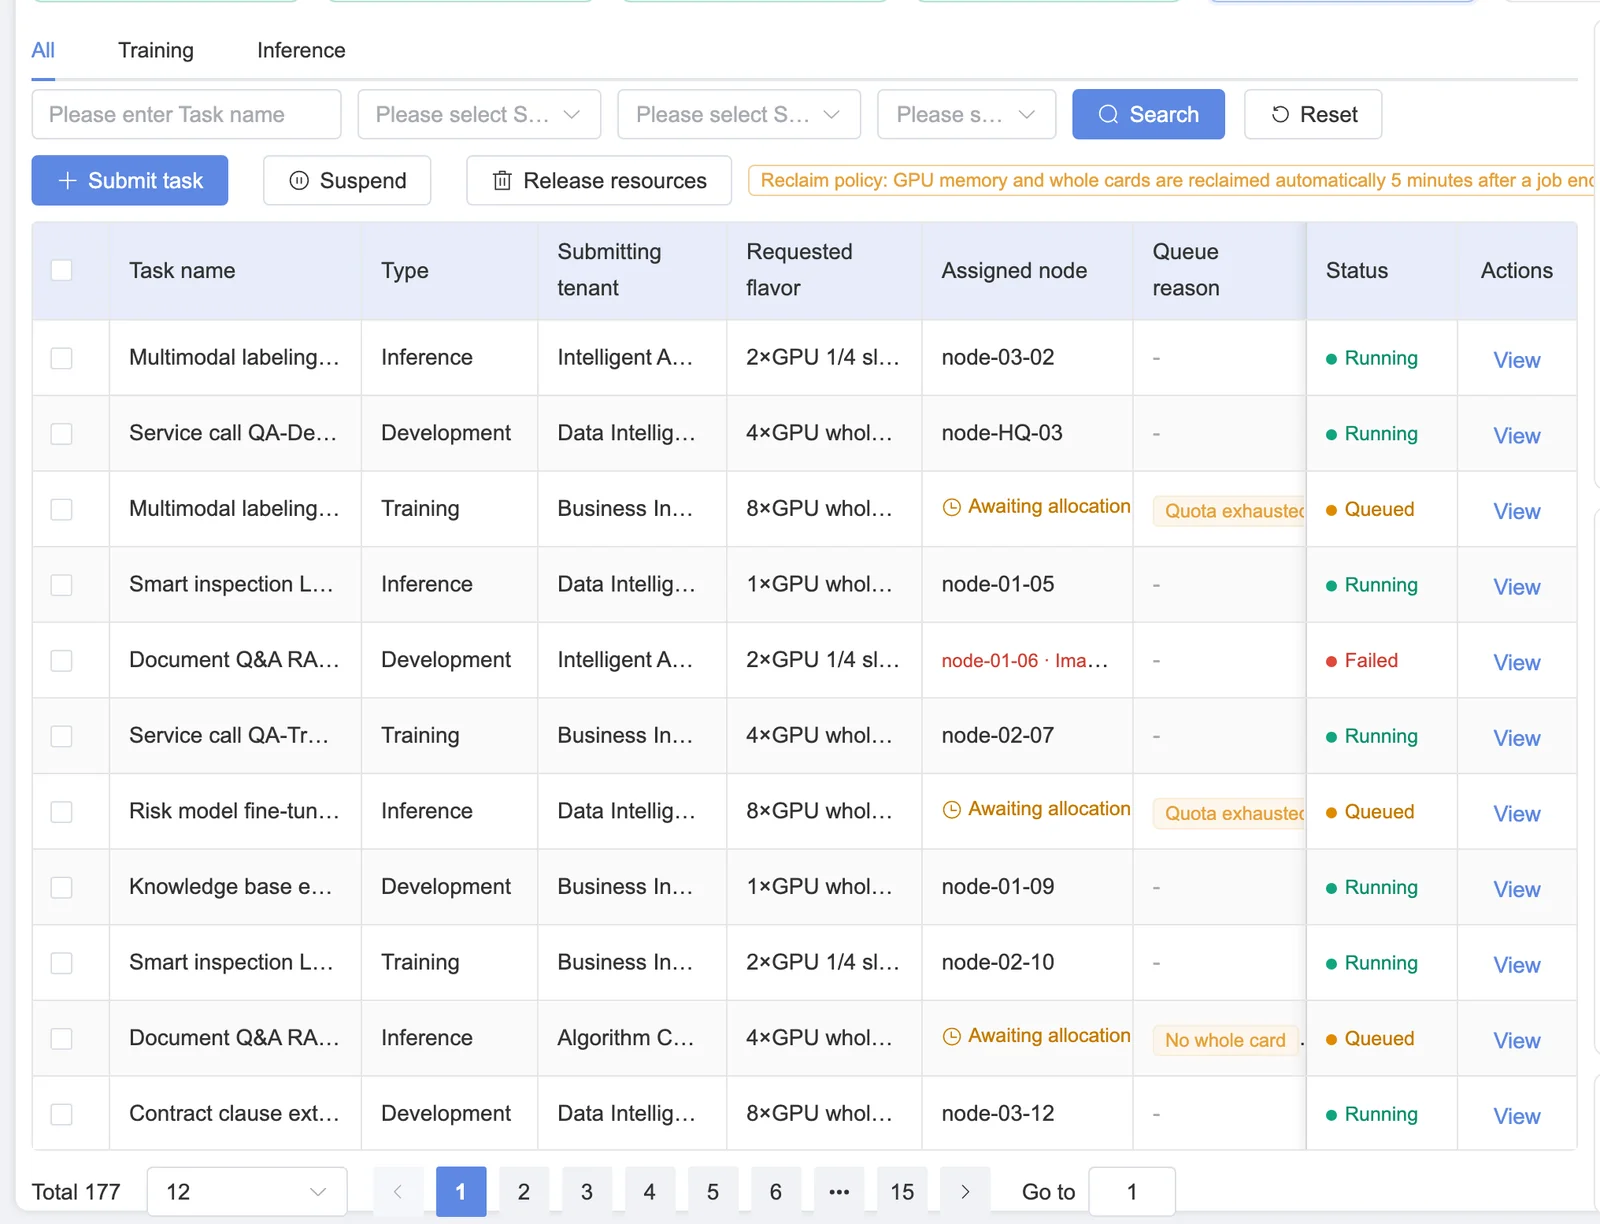
Śledzenie każdego zadania treningowego i usługi wnioskowania od kolejki do zwolnienia zasobów
Sensaka odczytuje zadania ze Slurm i Kubernetes i pokazuje je w jednym widoku. Każde zadanie w kolejce ma podaną przyczynę oczekiwania, każde uruchomione zadanie zajmowane GPU, węzły i kontenery, a każde zakończone zadanie zużyte godziny GPU oraz, w razie niepowodzenia, sklasyfikowaną przyczynę błędu.
W przypadku długich przebiegów treningowych platforma oznacza degradujące się GPU, zanim ulegną awarii, pokazuje, kiedy i gdzie zapisano ostatni punkt kontrolny, wymusza zapis punktu kontrolnego przed wywłaszczeniem i mierzy czas treningu utracony w wyniku przerwania.
Podstawowe funkcje
- Przyczyny oczekiwania w kolejce, priorytet i wywłaszczanie dla każdego zadania
- GPU, węzły i kontenery zajmowane przez każde zadanie
- Wykorzystanie GPU, zasilanie i kondycja dla każdego zadania treningowego
- Godziny GPU na zadanie w odniesieniu do limitu dzierżawcy
- Wskaźnik powodzenia zadań i sklasyfikowane przyczyny niepowodzeń
- Sygnały degradacji: ECC pamięci, błędy NVLink, wolne GPU
- Czas, lokalizacja i czas zapisu punktów kontrolnych
- Czas do pierwszego tokena, przepustowość i współczynnik błędów dla każdej usługi modelu
Wartość biznesowa
Skrócenie czasu od spowolnionego lub nieudanego zadania do ustalenia jego przyczyny oraz ochrona wielodniowego przebiegu treningowego przed skutkami awarii jednej karty.
Śledzenie każdego obciążenia aż do karty akceleratora
Platforma buduje dynamiczne relacje między obciążeniami, kontenerami, GPU, węzłami i pulami zasobów. Operatorzy mogą sprawdzić, które kontenery korzystają z danego GPU, oraz zobaczyć, które karty akceleratorów zostały przypisane do konkretnego kontenera.
Sensaka monitoruje również żądaną pamięć GPU, limity zasobów i rzeczywiste szczytowe zużycie, rejestrując przy tym zdarzenia przypisania i zwolnienia GPU na potrzeby analizy zasobów, analizy incydentów i audytu.
Podstawowe funkcje
- Dwukierunkowe wyszukiwanie GPU i kontenerów
- Mapowanie relacji między identyfikatorem UUID GPU a kontenerem
- Chronologia przypisań i zwolnień GPU
- Analiza żądanej, limitowanej i szczytowej pamięci kontenera
- Identyfikacja obciążeń o wysokim przydziale i niskim wykorzystaniu
- Korelacja między awariami kontenerów a nadmiernym przydziałem zasobów
Analiza GPU, sieci treningowych i pamięci masowej na jednej osi czasu
Niskie wykorzystanie GPU nie zawsze oznacza niewystarczające zapotrzebowanie na moc obliczeniową. Utrata pakietów w sieci, niewystarczająca przepustowość pamięci masowej, wolne wczytywanie danych lub problemy sprzętowe mogą zmuszać GPU do oczekiwania, pozostawiając kosztowne zasoby obliczeniowe bezczynne.
Sensaka zestawia wykorzystanie GPU, przepustowość sieci, utratę pakietów, błędy i stan portów, przepustowość pamięci masowej, IOPS, opóźnienia odczytu i zapisu oraz kondycję węzłów na wspólnej osi czasu operacji.
Podstawowe funkcje
- Zsynchronizowana w czasie analiza metryk GPU, sieci i pamięci masowej
- Liczniki utraty pakietów, błędów i stanu portów w sieci treningowej
- Analiza przepustowości, IOPS i opóźnień pamięci masowej
- Identyfikacja wąskich gardeł wczytywania danych i zapisu punktów kontrolnych
- Łączna analiza temperatury, zasilania, ECC i kondycji sprzętu
- Czteroetapowa pętla operacyjna obejmująca monitoring, analizę, diagnostykę i szeregowanie zadań
- Generowanie rekomendacji, autoryzowane wykonywanie działań i audyt operacyjny
Wartość biznesowa
Szybkie ustalenie, czy problem z wydajnością wynika z zasobów obliczeniowych, sieci, pamięci masowej czy infrastruktury sprzętowej.
Skrócenie czasu analizy między zespołami i ograniczenie ryzyka, że długo trwające zadania treningowe zostaną przerwane, zrestartowane lub będą bezproduktywnie zużywać zasoby.
Ujednolicony monitoring chłodzenia cieczą i infrastruktury obiektowej dla gęstej infrastruktury AI
W miarę jak rośnie zużycie energii przez serwery GPU i gęstość obciążenia szaf rack, chłodzenie cieczą staje się kluczowym elementem niezawodnego działania centrów danych AI.
Sensaka monitoruje status systemu chłodzenia cieczą, temperaturę na wlocie i wylocie, różnice ciśnień oraz powiązane wskaźniki środowiskowe. Metryki te są korelowane z gęstością mocy szaf rack, temperaturą, wilgotnością, wykrywaniem wycieków i danymi dystrybucji zasilania, aby pomóc operatorom identyfikować awarie chłodzenia i zagrożenia termiczne.
Podstawowe funkcje
- Monitoring statusu CDU i systemu chłodzenia cieczą
- Monitoring temperatury na wlocie i wylocie
- Monitoring różnicy ciśnień
- Monitoring temperatury i wilgotności
- Monitoring zdarzeń wycieku cieczy
- Analiza gęstości mocy na poziomie szafy rack
- Identyfikacja przeciążonych szaf rack i gorących punktów termicznych
- Monitoring dystrybucji zasilania i obwodów PDU
- Łączna analiza przestrzeni w szafie rack, zasilania i wydajności chłodzenia
Wartość biznesowa
Włączenie monitoringu chłodzenia cieczą w szersze środowisko operacyjne infrastruktury AI.
Identyfikacja zagrożeń związanych z temperaturą, ciśnieniem, wyciekami i pojemnością, zanim wpłyną na gęste klastry GPU.
Zasilanie, chłodzenie i energia pod stosem AI
Platformy do serwowania modeli i szeregowania zadań nie widzą obiektu. Sensaka widzi: gęstość mocy szaf rack, obwody PDU, odczyty chłodzenia i chłodzenia cieczą, temperatura i wilgotność znajdują się w tej samej platformie co zależne od nich GPU i zadania.
Dane o energii są przekształcane we wskaźniki PUE i WUE, koszt energii na projekt i na token oraz raportowanie wymagane od centrów danych w UE na mocy dyrektywy w sprawie efektywności energetycznej.
Podstawowe funkcje
- Mapa cieplna gęstości mocy szaf rack z alertami przekroczenia limitów
- PUE i WUE dla obiektu i poszczególnych stref, na żywo i jako trend
- Koszt energii przypisany do projektów, dzierżawców i tokenów
- Porównanie efektywności stref chłodzonych cieczą i powietrzem
- Śledzenie energii i emisji na potrzeby raportowania EU EED
- Trendy pojemności wspierające decyzje o rozbudowie
Przekształcenie inwentaryzacji zasobów w podstawę danych o relacjach w czasie rzeczywistym
CMDB Sensaka to znacznie więcej niż statyczna lista urządzeń. Nieustannie rejestruje relacje między ludźmi, infrastrukturą fizyczną, działaniami operacyjnymi, zasobami obliczeniowymi i usługami biznesowymi.
Ta wspólna podstawa danych wspiera monitoring, szeregowanie zadań, pomiar zużycia, zarządzanie alarmami, zgłoszenia serwisowe i analizę wpływu biznesowego.
Podstawowe funkcje
- Automatyczne wykrywanie urządzeń i komponentów
- Zarządzanie relacjami centrum danych, szafy rack i jednostki rack
- Ujednolicona inwentaryzacja serwerów, GPU, sieci, pamięci masowej i systemów chłodzenia cieczą
- Śledzenie relacji obciążeń, kontenerów, węzłów i akceleratorów
- Powiązania dzierżawców, projektów, zespołów i właścicieli
- Śledzenie zmian konfiguracji i migawki historyczne
- Automatyczna analiza wpływu dzięki mapowaniu relacji
- Jedno wspólne źródło konfiguracji dla monitoringu, szeregowania zadań, pomiaru zużycia i zarządzania usługami
Połączenie z chmurami, ITSM, CMDB i systemami alertów bez ich zastępowania
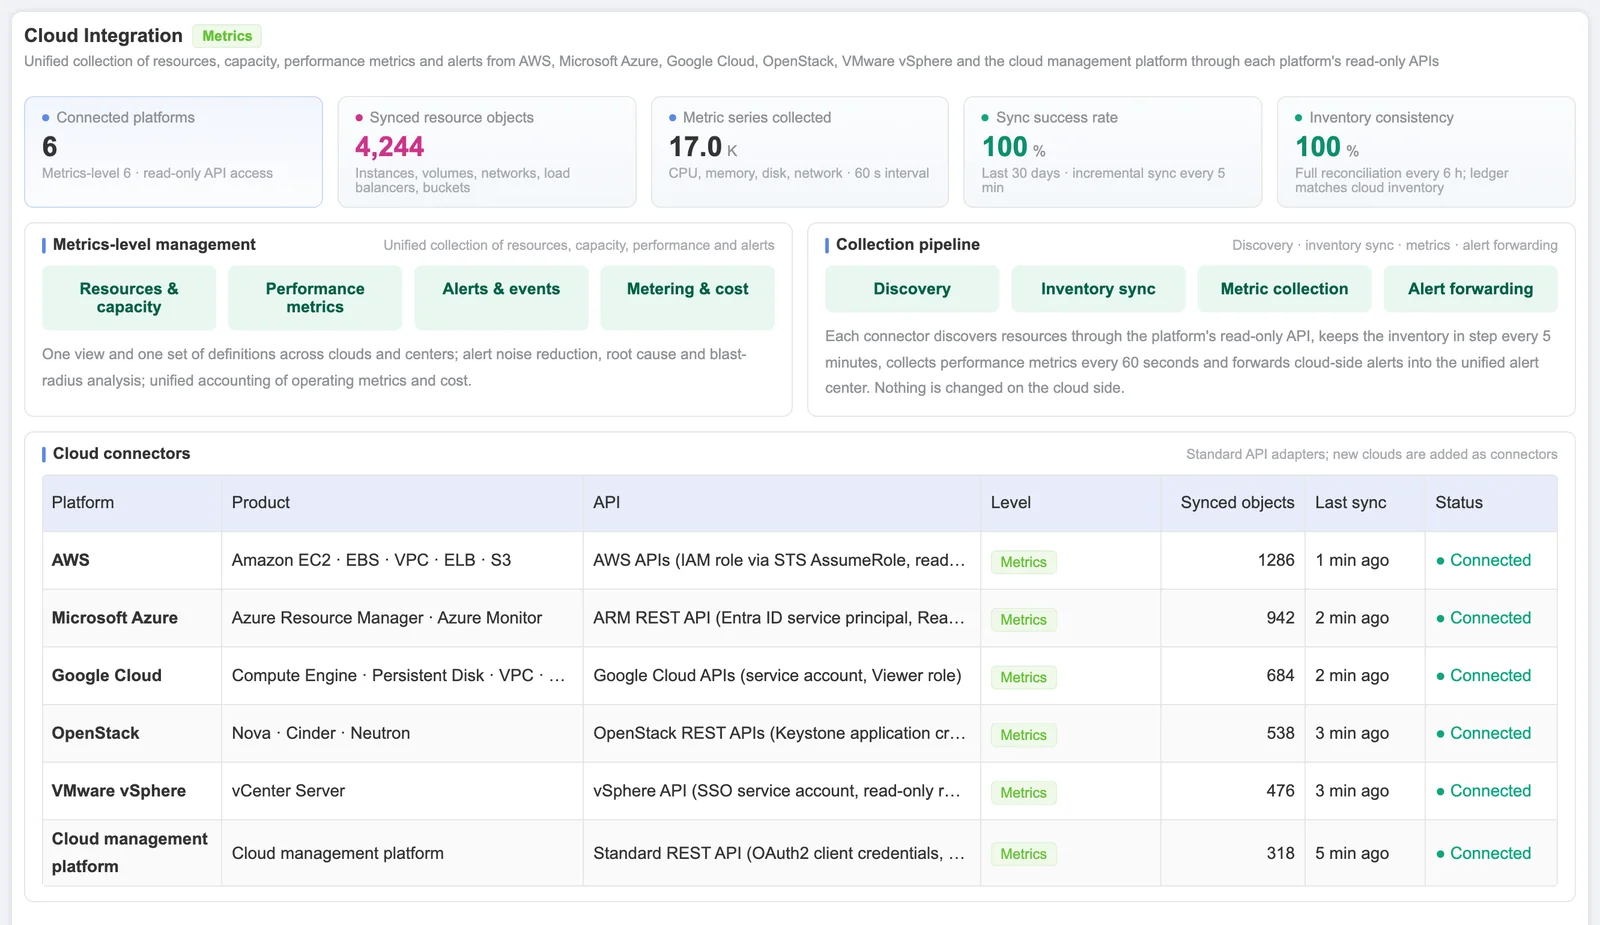
Sensaka zbiera dane o zasobach, pojemności, wydajności i alarmach z AWS, Microsoft Azure, Google Cloud, OpenStack i VMware na poziomie metryk, dzięki czemu lokalne klastry GPU i pojemność chmurowa są liczone według tych samych definicji. Zmiany zasobów chmurowych pozostają w narzędziach poszczególnych chmur.
W kierunku northbound platforma synchronizuje rekordy CMDB i zgłoszenia z ServiceNow lub Jira, kieruje skorelowane alerty do PagerDuty, OpsGenie, Slack, poczty e-mail lub webhooka oraz udostępnia REST API i webhooki dla Państwa własnych systemów.
Podstawowe funkcje
- Zbieranie danych na poziomie metryk z AWS, Azure, GCP, OpenStack i VMware
- Synchronizacja CMDB i zgłoszeń z ServiceNow lub Jira
- Wzbogacanie CMDB o dane sprzętowe odczytane z BMC
- Kierowanie alertów do PagerDuty, OpsGenie, Slack, poczty e-mail lub webhooka
- REST API i webhooki
- Zbieranie danych in-band i out-of-band przez 14 protokołów
Zbudowana na warstwach DCIM, ITSM i AIOps Sensaka
Platforma AI nie jest osobną, nową bazą kodu. Działa na tych samych modułach co Sensaka for Data Centers, produkt dla konwencjonalnych centrów danych. Platforma bazowa działa produkcyjnie od 9+ lat i monitoruje 3M+ urządzeń w swojej bazie wdrożeń.
Od monitoringu infrastruktury do operacji w zamkniętej pętli
Sensaka for AI Data Centers łączy wykrywanie zasobów, wdrażanie urządzeń, łączenie zasobów w pule, żądania obciążeń, inteligentne szeregowanie, pomiar zużycia, analitykę i optymalizację operacyjną. Wnioski z analizy operacyjnej można wykorzystać do dostosowania specyfikacji zasobów, polityk szeregowania, limitów i zakresu zarządzania, tworząc ciągłą pętlę optymalizacji.
Gotowość zasobów
Automatyczne wykrywanie urządzeń, zarządzanie heterogenicznymi zasobami obliczeniowymi oraz tworzenie ustandaryzowanych pul zasobów i specyfikacji.
Dostarczanie obciążeń
Przydzielanie zasobów obliczeniowych obciążeniom związanym z trenowaniem, wnioskowaniem i pracami programistycznymi za pomocą kolejek, limitów projektowych i polityk szeregowania.
Optymalizacja operacyjna
Ciągła optymalizacja przydziału zasobów i polityk operacyjnych na podstawie danych o wykorzystaniu, statusie obciążeń, wydajności zasobów obliczeniowych, sieci i pamięci masowej, kondycji sprzętu oraz kosztach.
Stworzone dla każdego środowiska infrastruktury AI
Centra danych AI klasy enterprise
Zarządzanie serwerami GPU, siecią, pamięcią masową, infrastrukturą chłodzenia cieczą i szeregowaniem obciążeń w jednej platformie w celu zwiększenia wewnętrznego wykorzystania zasobów.
Publiczne centra obliczeniowe
Tworzenie wielodzierżawczych pul zasobów, limitów projektowych, kolejek obciążeń i raportowania zużycia w celu usprawnienia dostarczania zasobów i działalności komercyjnej.
Usługi finansowe i branże o wysokich wymaganiach dostępności
Wykorzystanie zbierania danych in-band i out-of-band, monitoringu na poziomie komponentów, analizy wpływu awarii i podlegających audytowi procesów operacyjnych w celu ochrony krytycznych usług trenowania i wnioskowania.
Telekomunikacja i środowiska wielolokalizacyjne
Scentralizowane zarządzanie regionalnymi centrami danych, rozproszonymi klastrami, zasobami infrastruktury i danymi operacyjnymi w wielu lokalizacjach.
Uczelnie i organizacje badawcze
Zarządzanie wnioskami o GPU, limitami, przydziałem, wykorzystaniem i zwalnianiem zasobów w zespołach badawczych, działach i projektach.
Co się zmienia, gdy każdy akcelerator jest zarządzany
Pełna widoczność zasobów obliczeniowych
Widoczność GPU, NPU, serwerów, sieci, pamięci masowej, sprzętu do chłodzenia cieczą i zasobów szaf rack w jednej platformie.
Lepsze wykorzystanie zasobów
Ograniczenie marnotrawstwa zasobów obliczeniowych dzięki łączeniu zasobów w pule, zarządzaniu specyfikacjami, szeregowaniu obciążeń i identyfikacji bezczynnych zasobów.
Szybsze rozwiązywanie problemów
Wykorzystanie korelacji GPU i kontenerów wraz z analizą zasobów obliczeniowych, sieci i pamięci masowej w celu szybszej identyfikacji wąskich gardeł i wpływu biznesowego.
Ochrona stabilności trenowania i wnioskowania
Wykrywanie zagrożeń związanych ze sprzętem, siecią, pamięcią masową, temperaturą i chłodzeniem cieczą, zanim przerwą działanie obciążeń.
Budowa wiarygodnej podstawy danych operacyjnych
Powiązanie zasobów, obciążeń, projektów, pracowników, kosztów i usług biznesowych na potrzeby decyzji operacyjnych i zarządczych.
Poznaj rozwiązania Sensaka dla infrastruktury AI
Najczęściej zadawane pytania
Czym jest zarządzanie infrastrukturą AI?
Zarządzanie infrastrukturą AI to utrzymywanie produktywności centrum danych AI lub fabryki AI: wiedza o tym, gdzie znajduje się każdy akcelerator i w jakim jest stanie, sprawiedliwy przydział pojemności GPU, śledzenie zadań, nadzór nad zasilaniem i chłodzeniem oraz rozliczanie godzin GPU i tokenów. Sensaka realizuje to w jednej platformie z jedną inwentaryzacją.
Czy AI Cockpit korzysta z zewnętrznego modelu AI?
Nie. AI Cockpit dopasowuje pytania lokalnie do predefiniowanych pytań operacyjnych i tworzy pulpit oraz wideo z danych, które już znajdują się w platformie. Działa on-premises, a Państwa dane nie opuszczają centrum danych.
Jakie akceleratory obsługuje platforma?
Akceleratory NVIDIA, AMD i inne. Obsługiwane modele i pola zależą od interfejsów zarządzania poszczególnych producentów i są potwierdzane dla Państwa sprzętu podczas rozmowy o zakresie przed pilotażem.
Czy Sensaka to oprogramowanie do monitoringu GPU, czy harmonogram zadań?
To oprogramowanie do monitoringu GPU i platforma operacyjna współpracująca z Państwa harmonogramami zadań. Sensaka odczytuje zadania ze Slurm i Kubernetes, zarządza pulami, specyfikacjami i limitami oraz monitoruje sprzęt i obiekt pod spodem; nie zastępuje używanego harmonogramu zadań.
Jak zacząć?
Od bezpłatnego 30-dniowego pilotażu on-premises na części Państwa środowiska, z kryteriami sukcesu uzgodnionymi przed jego rozpoczęciem. Publiczne ceny katalogowe warstw DCIM i monitoringu platformy znajdują się na stronie cennika; partnerzy, którzy odsprzedają lub integrują Sensaka, uzyskują 25% marży w pierwszym roku.
Każdy akcelerator widoczny, zarządzalny, planowalny i mierzalny
Sensaka for AI Data Centers pomaga organizacjom zarządzać infrastrukturą AI i heterogenicznymi zasobami obliczeniowymi w jednym, ujednoliconym środowisku. Tworzy kompletną pętlę operacyjną: od monitoringu urządzeń i szeregowania zasobów GPU, przez koordynację zasobów obliczeniowych, sieci i pamięci masowej, monitoring chłodzenia cieczą i CMDB, aż po pomiar zużycia i optymalizację operacyjną.
Pilotaż trwa 30 dni, odbywa się on-premises, jest bezpłatny, a kryteria sukcesu są uzgadniane przed jego rozpoczęciem.
Integratorzy i resellerzy: program partnerski Sensaka oferuje 25% marży w pierwszym roku. Zapraszamy do kontaktu.