KI-Infrastrukturmanagement für KI-Rechenzentren und KI-Fabriken
KI-Infrastrukturmanagement auf einer On-Premises-Plattform: Stellen Sie dem AI Cockpit eine Frage in natürlicher Sprache und erhalten Sie ein individuelles Dashboard und ein 30-sekündiges Datenvideo, erstellt aus demselben Inventar, das Ihre GPU-Pools, Jobs, Ihr Facility-Monitoring und Ihr Metering steuert.
Sensaka for AI Data Centers verbindet KI-Infrastruktur, heterogene Compute-Ressourcen, GPU-Cluster, Trainings- und Inferenz-Workloads, Netzwerke, Storage, Flüssigkeitskühlsysteme und Betriebsprozesse in einer Plattform. Es verwandelt fragmentierte Compute-Ressourcen in Geschäftsfähigkeiten, die überwacht, eingeplant, gemessen und kontinuierlich optimiert werden können.
Von Flüssigkeitskühlsystemen, Servern und Beschleunigerkarten im Rechenzentrum bis hin zu Ressourcen-Pools, Workload-Scheduling, Alarmen, Service-Tickets, CMDB, Kostenerfassung und Betriebsanalysen baut die Plattform auf einer gemeinsamen Datengrundlage einen einheitlichen Betriebszyklus auf.
Von der Infrastrukturbereitstellung zum kontinuierlichen Betrieb
Sobald ein AI-Rechenzentrum gebaut ist, verschieben sich die Management-Prioritäten von Infrastrukturbereitstellung und Hardware-Menge hin zu Compute-Auslastung, Erfolgsquoten von Workloads, Servicequalität, Betriebskosten und Geschäftsergebnis.
Klassische Monitoring-Plattformen können Betreibern in der Regel sagen, ob ein Gerät online ist. Sie können jedoch kaum erklären, ob Compute-Ressourcen effektiv genutzt werden, warum Trainingsjobs warten, ob geringe GPU-Auslastung durch Engpässe bei Compute, Netzwerk oder Storage verursacht wird, oder welche Workloads und Business Services von einem Hardwareausfall betroffen sein werden.
Sensaka for AI Data Centers verbindet fünf operative Dimensionen: Menschen, physische Infrastruktur, Aktivitäten, Compute-Ressourcen und Business Services.
Sie führt Infrastrukturstatus, Compute-Ressourcen, Workload-Beziehungen, Service-Bereitstellung, Mitarbeiterverantwortung und Betriebs-Workflows in einer einheitlichen Management-Umgebung zusammen und hilft Organisationen, von einem Infrastrukturbereitstellungsmodell zu kontinuierlichem AI-Rechenzentrumsbetrieb überzugehen.
Eine Frage stellen, ein Dashboard und ein 30-sekündiges Datenvideo erhalten
Feste Dashboards beantworten die Fragen, die jemand vorab eingeplant hat. Das AI Cockpit beantwortet die Frage, die heute gestellt wird. Geben Sie eine Frage in natürlicher Sprache ein, und die Plattform erstellt dafür aus den bereits vorhandenen Daten ein Dashboard in natürlicher Sprache und rendert es anschließend als kurzes Video, wenn das Board zu dicht ist, um es durchzusprechen.
Fragen
Geben Sie eine Frage oder Stichwörter ein, etwa welche GPUs ungenutzt sind oder welche Mandanten kurz vor ihrer Quote stehen.
Zuordnen
Die Frage wird lokal vordefinierten Betriebsfragen zugeordnet, jeweils mit Datenquelle, Regel, Schwellenwert und empfohlener Maßnahme.
Board
Für diese Frage wird ein individuelles Dashboard erstellt: Top-Einträge, Aufschlüsselungen und Vergleiche, jeweils mit Drill-down bis zu den Datensätzen.
Video
Ein Klick rendert das Board im Browser als 30-sekündiges Datenvideo, bereit für ein Management-Meeting.
Läuft On-Premises. Fragen werden lokal zugeordnet, es wird kein externes Sprachmodell aufgerufen, und Betriebsdaten bleiben in Ihrem Rechenzentrum.
Das Video wird im Browser gezeichnet und kodiert, mit Untertiteln aus den Zahlen des Boards selbst, sodass es genau das aussagt, was das Board zeigt.
Erfassung, Daten, Services und Cockpit auf einem Datenbestand
Die Plattform ist in Schichten aufgebaut. Die Erfassung liest die physische Umgebung In-Band und Out-of-Band aus. Eine einzige Datengrundlage enthält CMDB-Beziehungen, Zeitreihen, Ereignisse und Nutzungsdatensätze. Services für Pools, Jobs, Metering, Alarme, Tickets und Workflows laufen auf diesen Daten, und darüber liegen die Cockpits. Integrationsschnittstellen verbinden jede Schicht mit den Clouds und Tools, die Sie bereits einsetzen.
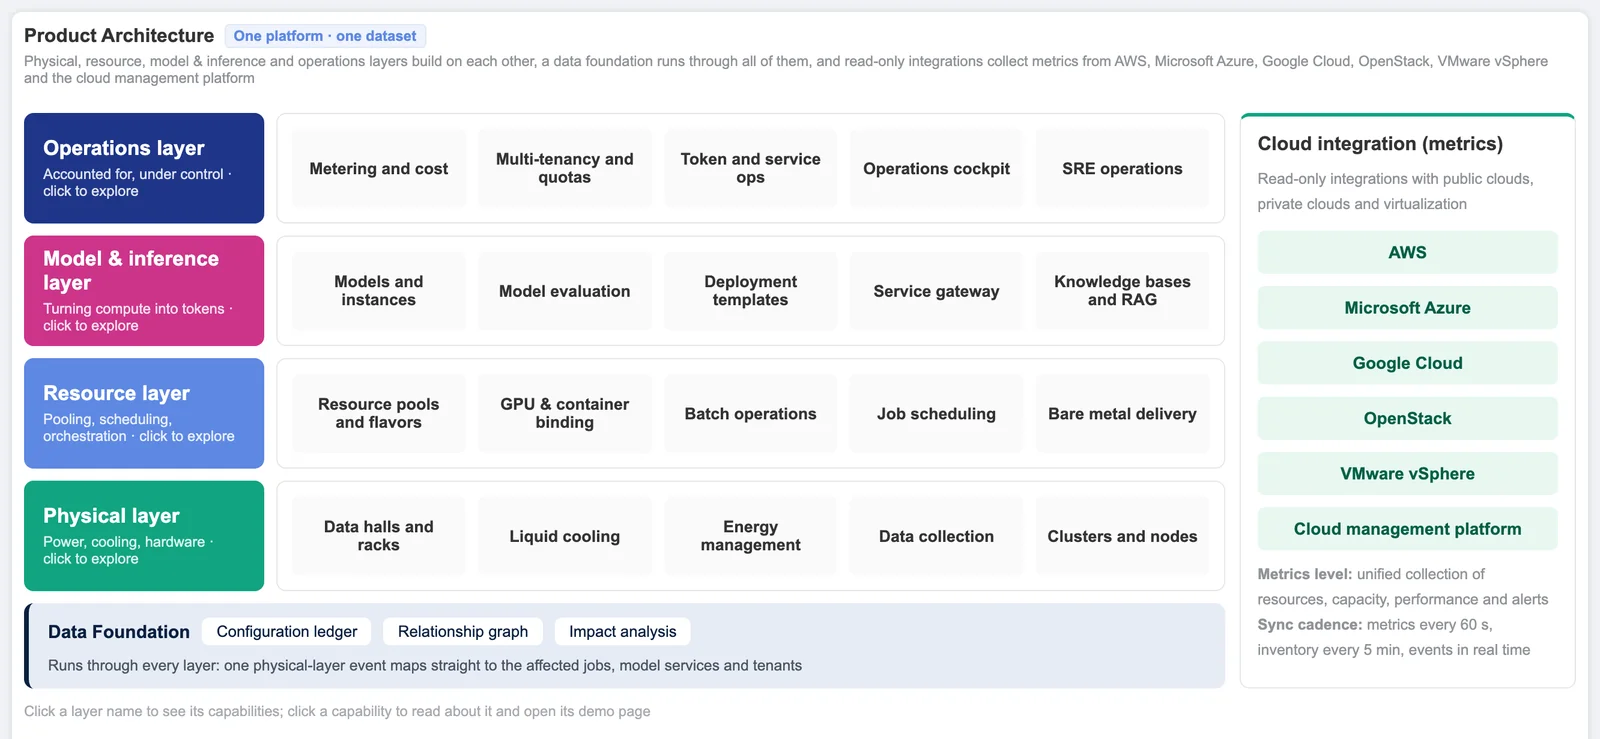
Dieselbe Plattform bedient Enterprise-KI-Rechenzentren, KI-Fabriken, die GPU-Kapazität oder Tokens an Mandanten verkaufen, und Forschungscluster, die abteilungsübergreifend genutzt werden. Sie wird On-Premises bereitgestellt und läuft ohne Internetverbindung.
Eine Plattform für einheitliches AI-Rechenzentrumsmanagement
Einheitliches Monitoring
Zentralisieren Sie Status, Performance, Kapazität und Alarme von Servern, Beschleunigerkarten, Netzwerken, Storage-Systemen, Racks, Stromsystemen, Flüssigkeitskühlungsanlagen und Umgebungsinfrastruktur.
Einheitliches Management
Nutzen Sie eine AI-Infrastruktur-CMDB, um Echtzeit-Beziehungen zwischen Rechenzentren, Geräten, Beschleunigerkarten, Clustern, Workloads, Projekten, Teams und Business Services herzustellen.
Einheitliches Scheduling
Wandeln Sie verteilte physische Compute-Ressourcen in standardisierte Ressourcen-Pools um, die angefordert, zugewiesen, freigegeben und gesteuert werden können.
Einheitliche Verbrauchsmessung
Erfassen Sie Beschleuniger-Stunden, Ressourcenverbrauch, Energieverbrauch und Betriebsdaten nach Projekt, Mandant und Ressourcentyp.
Einheitlicher Betrieb
Verbinden Sie Monitoring, Analyse, Diagnose, Alarme, Service-Tickets, Freigaben und Scheduling-Aktionen zu einem vollständigen Betriebs-Workflow.
Multi-Vendor-GPU- und NPU-Ressourcen in einer Plattform verwalten
AI-Rechenzentren enthalten häufig Beschleuniger-Hardware unterschiedlicher Hersteller, Modelle und Architekturen. Sensaka bietet einheitliches Management heterogener Compute-Ressourcen über diese Umgebungen hinweg.
Die Plattform identifiziert Beschleunigertypen in jedem Node, führt GPUs und NPUs unterschiedlicher Hersteller in einem gemeinsamen Inventar zusammen und stellt Beziehungen zwischen Beschleunigermodell, Anzahl, physischem Node, Betriebsstatus und Ressourcenzuweisung her.
Kernfunktionen
- Automatische Identifikation von Multi-Vendor-GPUs und -NPUs
- Inventar für Beschleunigerkarten auf Komponentenebene
- Einheitliches Management über Regionen und Cluster hinweg
- Monitoring von Auslastung, Temperatur, Strom und Zustand auf Kartenebene
- Erkennung von Beschleuniger-Anomalien und Empfehlungen zur Isolation
- NVIDIA, AMD und andere Beschleuniger in einem Inventar
Geschäftlicher Nutzen
Reduzieren Sie die Abhängigkeit von separaten Herstellertools und verwalten Sie heterogene Compute-Ressourcen über ein einheitliches Interface.
So entsteht eine verlässliche Datengrundlage für Scheduling, Kapazitätsplanung, Infrastruktur-Governance und operative Entscheidungen.
GPU-Hardware in zuweisbare Compute-Ressourcen verwandeln
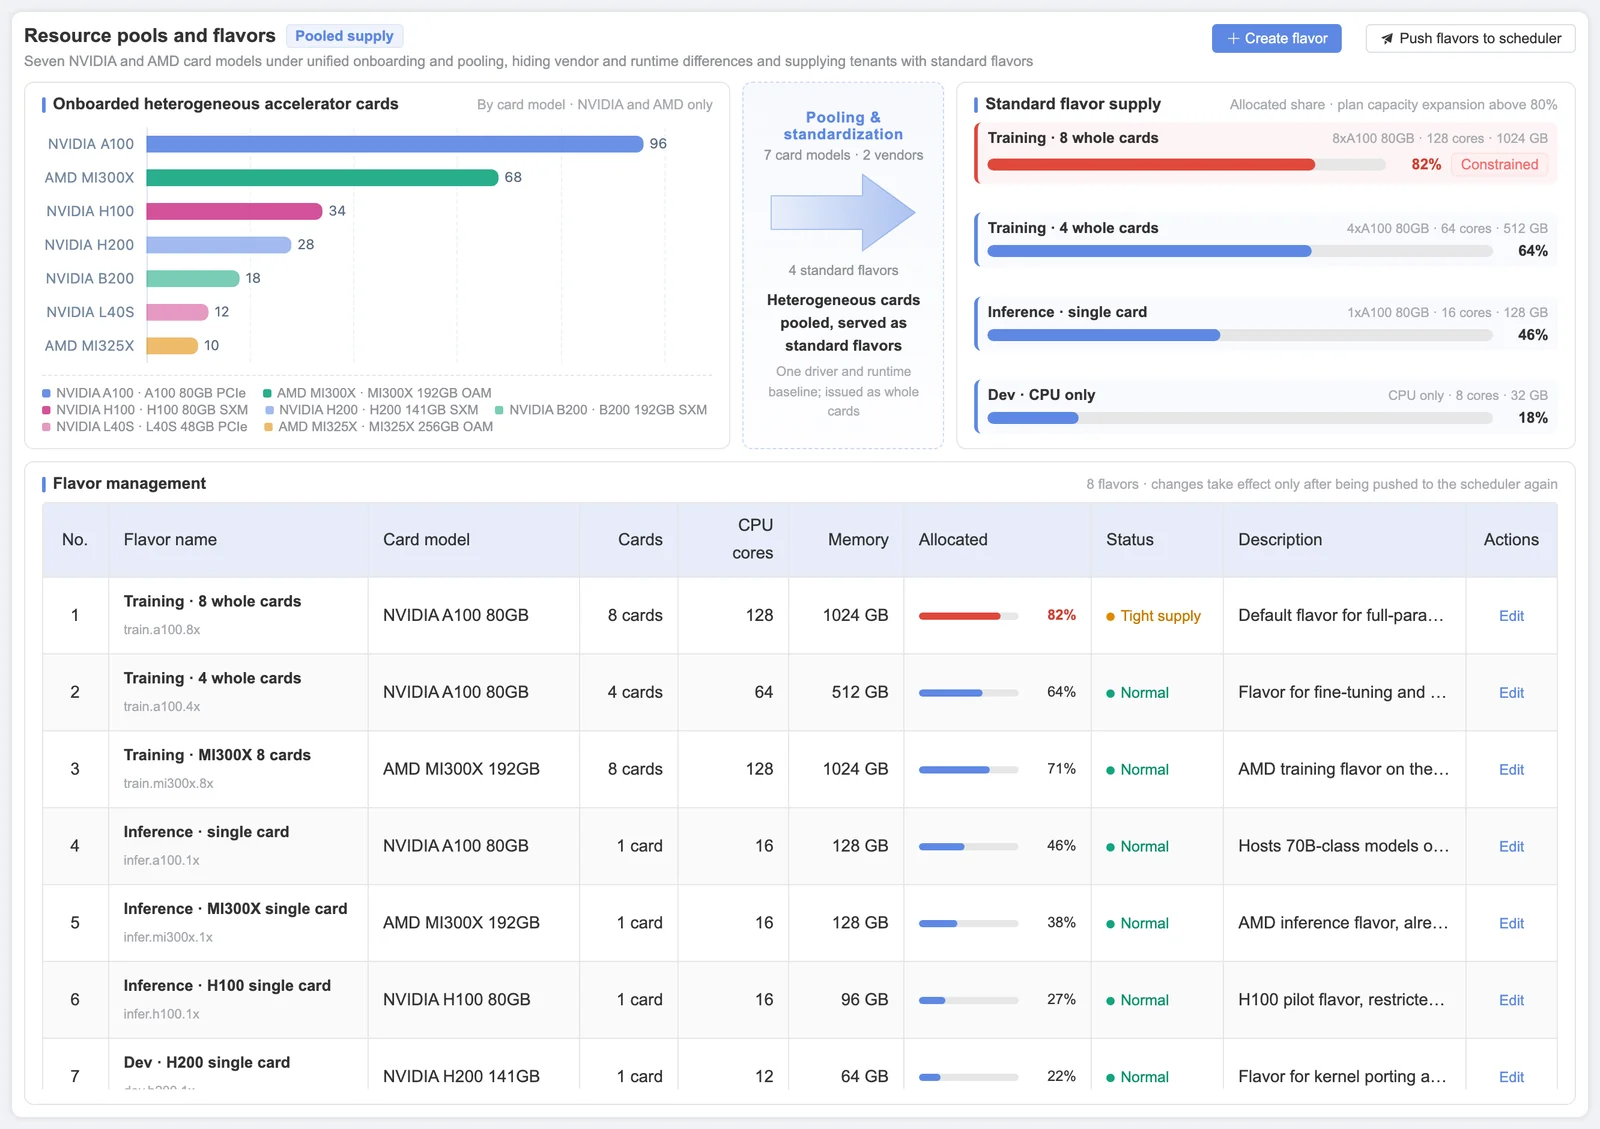
Sensaka abstrahiert physische Beschleunigerkarten zu Ressourcen-Pools und verwaltet Trainings-, Inferenz- und Entwicklungs-Workloads über standardisierte Spezifikationen, Mandantenquoten, Workload-Queues und Scheduling-Richtlinien.
Die Plattform stellt Kapazität als Standardspezifikationen bereit, wendet Mandantenquoten in GPU-Stunden, Tokens und Storage an, reiht Anfragen nach Priorität mit Preemption ein und gibt Ressourcen automatisch frei, wenn ein Workload abgeschlossen ist oder eine Zeitüberschreitung eintritt. Diese Funktionen helfen KI-Rechenzentren und KI-Fabriken, Fragmentierung, ungenutzte Ressourcen und ineffiziente Zuweisung zu reduzieren.
Neue Server gelangen über automatisierte Bare-Metal-Provisionierung in den Pool: BMC-Einrichtung, Betriebssysteminstallation per PXE, Treiber und Runtime sowie ein Burn-in-Gate, das fehlerhafte Hardware fernhält.
Kernfunktionen
- Pooling heterogener Compute-Ressourcen
- Ressourcenspezifikationen für Training, Inferenz und Entwicklung
- Klassifizierung von Trainings- und Inferenz-Workloads
- Verwaltung von Workload-Queues
- Quotenkontrollen für Projekte und Mandanten
- Zuweisung nach Standardspezifikation gegen Mandantenquoten
- Priorität, Ressourcengewichtung und Node-Filling-Strategien
- Automatische Ressourcenfreigabe nach Abschluss oder Timeout
- Isolierung fehlerhafter Knoten mit Bestätigung durch den Operator
- Erkennung ungenutzter GPUs anhand eines von Ihnen festgelegten Auslastungsschwellenwerts
- Bare-Metal-Provisionierung mit Burn-in-Gate, bevor ein Server dem Pool beitritt
Geschäftlicher Nutzen
Verbessern Sie die GPU-Auslastung, reduzieren Sie Überallokation und ungenutzte Kapazität, und priorisieren Sie Compute-Ressourcen für die wertvollsten Workloads.
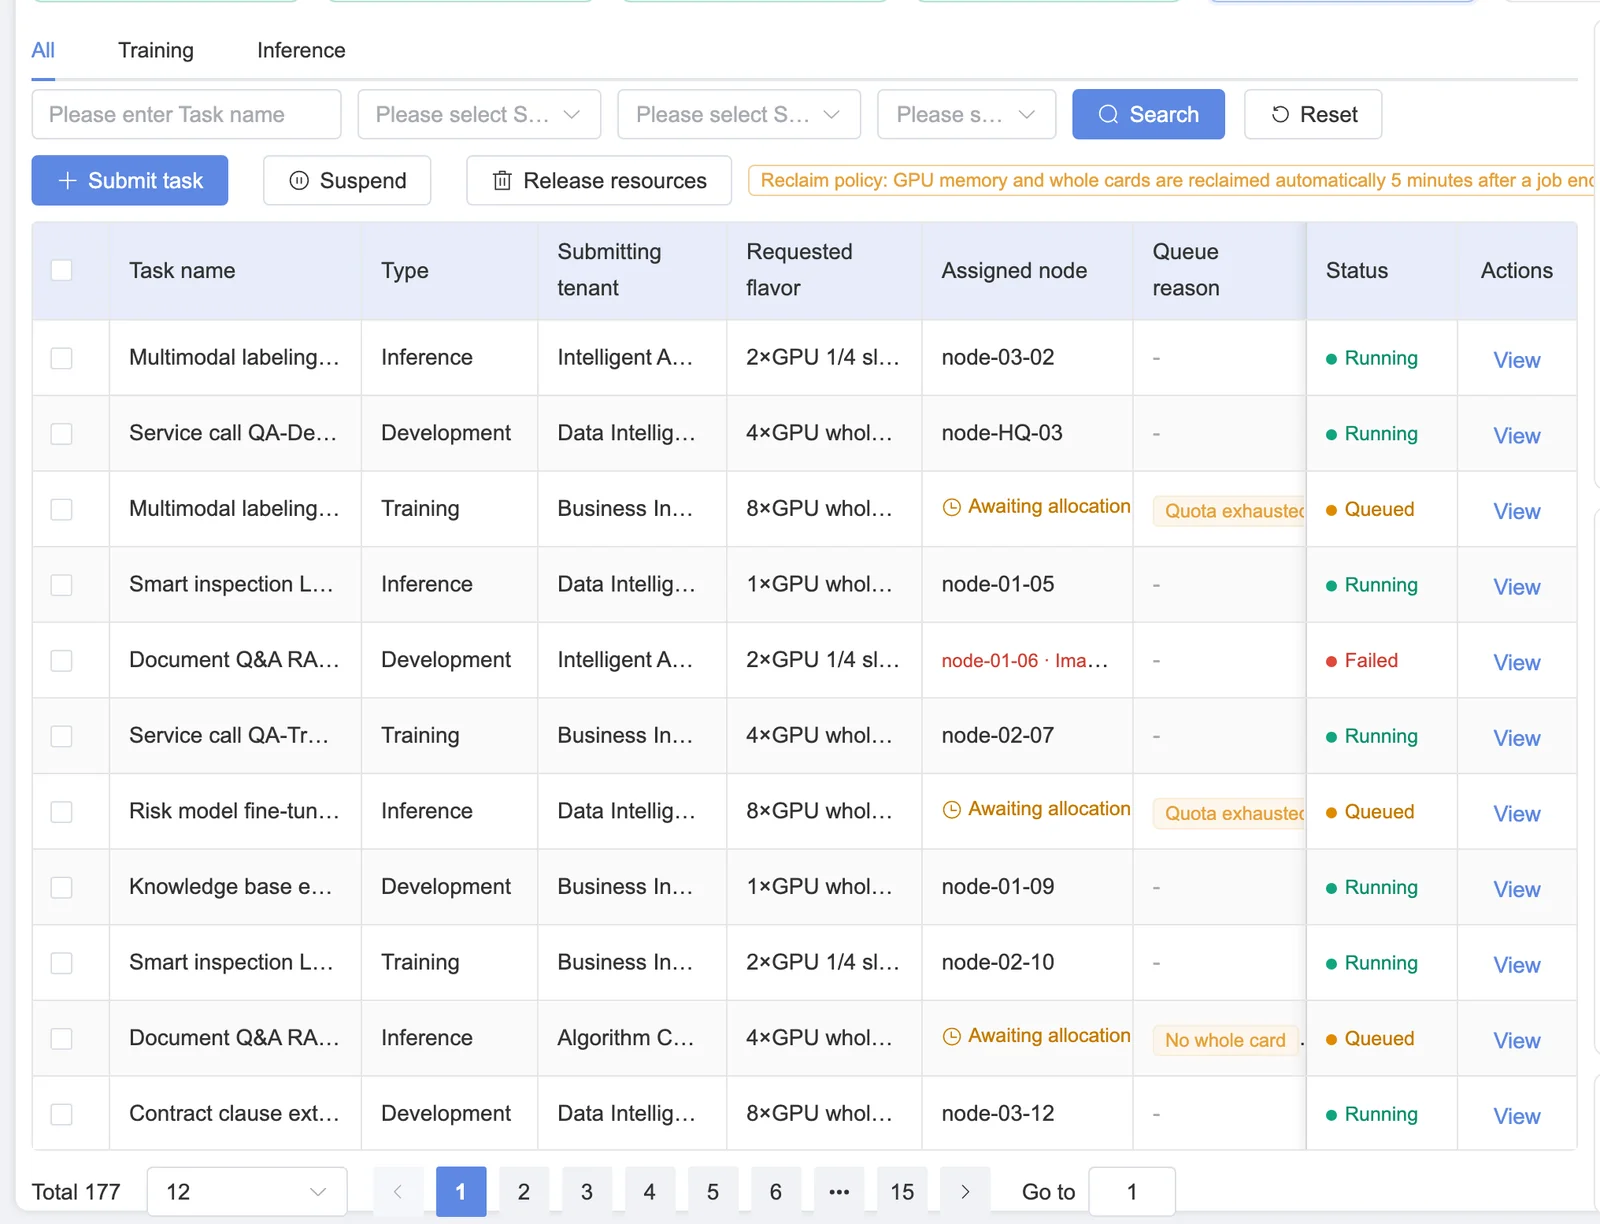
Jeden Trainingsjob und Inferenz-Service von der Queue bis zur Freigabe verfolgen
Sensaka liest Jobs aus Slurm und Kubernetes aus und zeigt sie in einer Ansicht. Jeder wartende Job trägt seinen Queue-Grund, jeder laufende Job die GPUs, Knoten und Container, die er belegt, und jeder abgeschlossene Job seine GPU-Stunden sowie, falls er fehlgeschlagen ist, einen klassifizierten Fehlergrund.
Bei langen Trainingsläufen markiert die Plattform nachlassende GPUs, bevor sie ausfallen, zeigt, wann und wo der letzte Checkpoint geschrieben wurde, erzwingt vor einer Preemption einen Checkpoint und misst die Trainingszeit, die eine Unterbrechung gekostet hat.
Kernfunktionen
- Queue-Gründe, Priorität und Preemption pro Job
- Von jedem Job belegte GPUs, Knoten und Container
- GPU-Auslastung, Leistungsaufnahme und Zustand pro Trainingsjob
- GPU-Stunden pro Job gemessen an der Mandantenquote
- Job-Erfolgsquote und klassifizierte Fehlergründe
- Degradationssignale: Speicher-ECC, NVLink-Fehler, langsame GPUs
- Zeitpunkt, Speicherort und Schreibdauer von Checkpoints
- Time to First Token, Durchsatz und Fehlerrate pro Modell-Service
Geschäftlicher Nutzen
Verkürzen Sie die Zeit von einem langsamen oder fehlgeschlagenen Job bis zu seiner Ursache, und verhindern Sie, dass eine einzige ausfallende Karte einen mehrtägigen Trainingslauf kostet.
Jeden Workload bis zur Beschleunigerkarte zurückverfolgen
Die Plattform stellt dynamische Beziehungen zwischen Workloads, Containern, GPUs, Nodes und Ressourcen-Pools her. Betreiber können erkennen, welche Container eine bestimmte GPU nutzen, und einsehen, welche Beschleunigerkarten einem bestimmten Container zugewiesen sind.
Sensaka überwacht zudem angeforderten GPU-Speicher, Ressourcenlimits und tatsächlichen Spitzenverbrauch und erfasst GPU-Bindungs- und Freigabeereignisse für Ressourcenanalyse, Vorfalluntersuchung und Auditing.
Kernfunktionen
- Bidirektionale GPU- und Container-Suche
- Zuordnung von GPU-UUID und Container-Beziehungen
- Zeitverläufe von GPU-Bindung und -Freigabe
- Analyse von angefordertem, limitiertem und maximalem Container-Speicher
- Identifikation von Workloads mit hoher Zuweisung und geringer Auslastung
- Korrelation zwischen Container-Ausfällen und Ressourcen-Überbuchung
GPUs, Trainingsnetzwerke und Storage auf einer Zeitachse analysieren
Geringe GPU-Auslastung bedeutet nicht immer unzureichende Compute-Nachfrage. Netzwerk-Paketverlust, unzureichender Storage-Durchsatz, langsames Laden von Daten oder Hardwareprobleme können GPUs zum Warten zwingen und teure Compute-Ressourcen ungenutzt lassen.
Sensaka führt GPU-Auslastung, Netzwerkdurchsatz, Paketverlust, Fehler und Portstatus, Storage-Durchsatz, IOPS, Lese- und Schreiblatenz sowie den Knotenzustand auf einer gemeinsamen operativen Zeitachse zusammen.
Kernfunktionen
- Zeitlich abgestimmte Analyse von GPU-, Netzwerk- und Storage-Metriken
- Zähler für Paketverlust, Fehler und Portstatus im Trainingsnetz
- Analyse von Storage-Durchsatz, IOPS und Latenz
- Identifikation von Engpässen beim Daten-Laden und Checkpoint-Schreiben
- Kombinierte Analyse von Temperatur, Strom, ECC und Hardwarezustand
- Ein vierstufiger Betriebszyklus aus Monitoring, Analyse, Diagnose und Scheduling
- Erstellung von Empfehlungen, autorisierte Ausführung und operatives Auditing
Geschäftlicher Nutzen
Erkennen Sie schnell, ob ein Performance-Problem von Compute, Netzwerk, Storage oder der Hardware-Infrastruktur ausgeht.
Reduzieren Sie die teamübergreifende Untersuchungszeit und verringern Sie das Risiko, dass lang laufende Trainingsjobs unterbrochen, neu gestartet werden oder Ressourcen ohne produktiven Ertrag verbrauchen.
Einheitliches Monitoring von Flüssigkeitskühlung und Facility für hochdichte AI-Infrastruktur
Da Stromverbrauch von GPU-Servern und Rack-Dichte weiter steigen, wird Flüssigkeitskühlung zu einem kritischen Bestandteil eines zuverlässigen AI-Rechenzentrumsbetriebs.
Sensaka überwacht den Status des Flüssigkeitskühlsystems, Zulauf- und Ablauftemperatur, Druckdifferenzen und verwandte Umgebungsindikatoren. Diese Metriken werden mit Rack-Leistungsdichte, Temperatur, Luftfeuchtigkeit, Leckerkennung und Stromverteilungsdaten korreliert, damit Betreiber Kühlausfälle und thermische Risiken erkennen können.
Kernfunktionen
- Monitoring von CDU- und Flüssigkeitskühlsystem-Status
- Monitoring von Zulauf- und Ablauftemperatur
- Monitoring von Druckdifferenzen
- Monitoring von Temperatur und Luftfeuchtigkeit
- Monitoring von Flüssigkeitsleckagen
- Analyse der Leistungsdichte auf Rack-Ebene
- Identifikation von Racks mit begrenzter Kapazität und thermischen Hotspots
- Monitoring von Stromverteilung und PDU-Stromkreisen
- Kombinierte Analyse von Rack-Fläche, Strom- und Kühlkapazität
Geschäftlicher Nutzen
Integrieren Sie Flüssigkeitskühlungs-Monitoring in die umfassendere AI-Infrastruktur-Betriebsumgebung.
Erkennen Sie Temperatur-, Druck-, Leckage- und Kapazitätsrisiken, bevor sie hochdichte GPU-Cluster beeinträchtigen.
Strom, Kühlung und Energie unter dem KI-Stack
Model-Serving- und Scheduling-Plattformen sehen die Facility nicht. Sensaka schon: Rack-Leistungsdichte, PDU-Stromkreise, Messwerte von Kühlung und Flüssigkeitskühlung, Temperatur und Luftfeuchtigkeit liegen in derselben Plattform wie die GPUs und Jobs, die davon abhängen.
Aus Energiedaten werden PUE und WUE, Energiekosten pro Projekt und pro Token sowie die Berichte, die ein Rechenzentrum in der EU nach der Energieeffizienzrichtlinie benötigt.
Kernfunktionen
- Heatmap der Rack-Leistungsdichte mit Grenzwertalarmen
- PUE und WUE für den Standort und pro Zone, live und als Trend
- Energiekosten, zugeordnet zu Projekten, Mandanten und Tokens
- Flüssigkeits- und luftgekühlte Zonen im Effizienzvergleich
- Energie- und Emissions-Tracking für das EU-EED-Reporting
- Kapazitätstrends als Grundlage für Erweiterungsentscheidungen
Das Asset-Inventar in eine Echtzeit-Beziehungsdatengrundlage verwandeln
Die Sensaka CMDB ist mehr als eine statische Geräteliste. Sie erfasst fortlaufend Beziehungen zwischen Personen, physischer Infrastruktur, Betriebsaktivitäten, Compute-Ressourcen und Business Services.
Diese gemeinsame Datengrundlage unterstützt Monitoring, Scheduling, Verbrauchsmessung, Alarmmanagement, Service-Tickets und Business-Impact-Analysen.
Kernfunktionen
- Automatische Geräte- und Komponentenerkennung
- Verwaltung von Beziehungen zwischen Rechenzentrum, Rack und Rack-Einheit
- Einheitliches Inventar für Server, GPUs, Netzwerke, Storage und Flüssigkeitskühlsysteme
- Nachverfolgung von Beziehungen zwischen Workload, Container, Node und Beschleuniger
- Zuordnungen von Mandant, Projekt, Team und Eigentümer
- Nachverfolgung von Konfigurationsänderungen und historische Snapshots
- Automatische Impact-Analyse durch Beziehungsmodellierung
- Eine gemeinsame Konfigurationsquelle für Monitoring, Scheduling, Verbrauchsmessung und Service-Management
Clouds, ITSM, CMDB und Alarmierung anbinden, ohne sie zu ersetzen
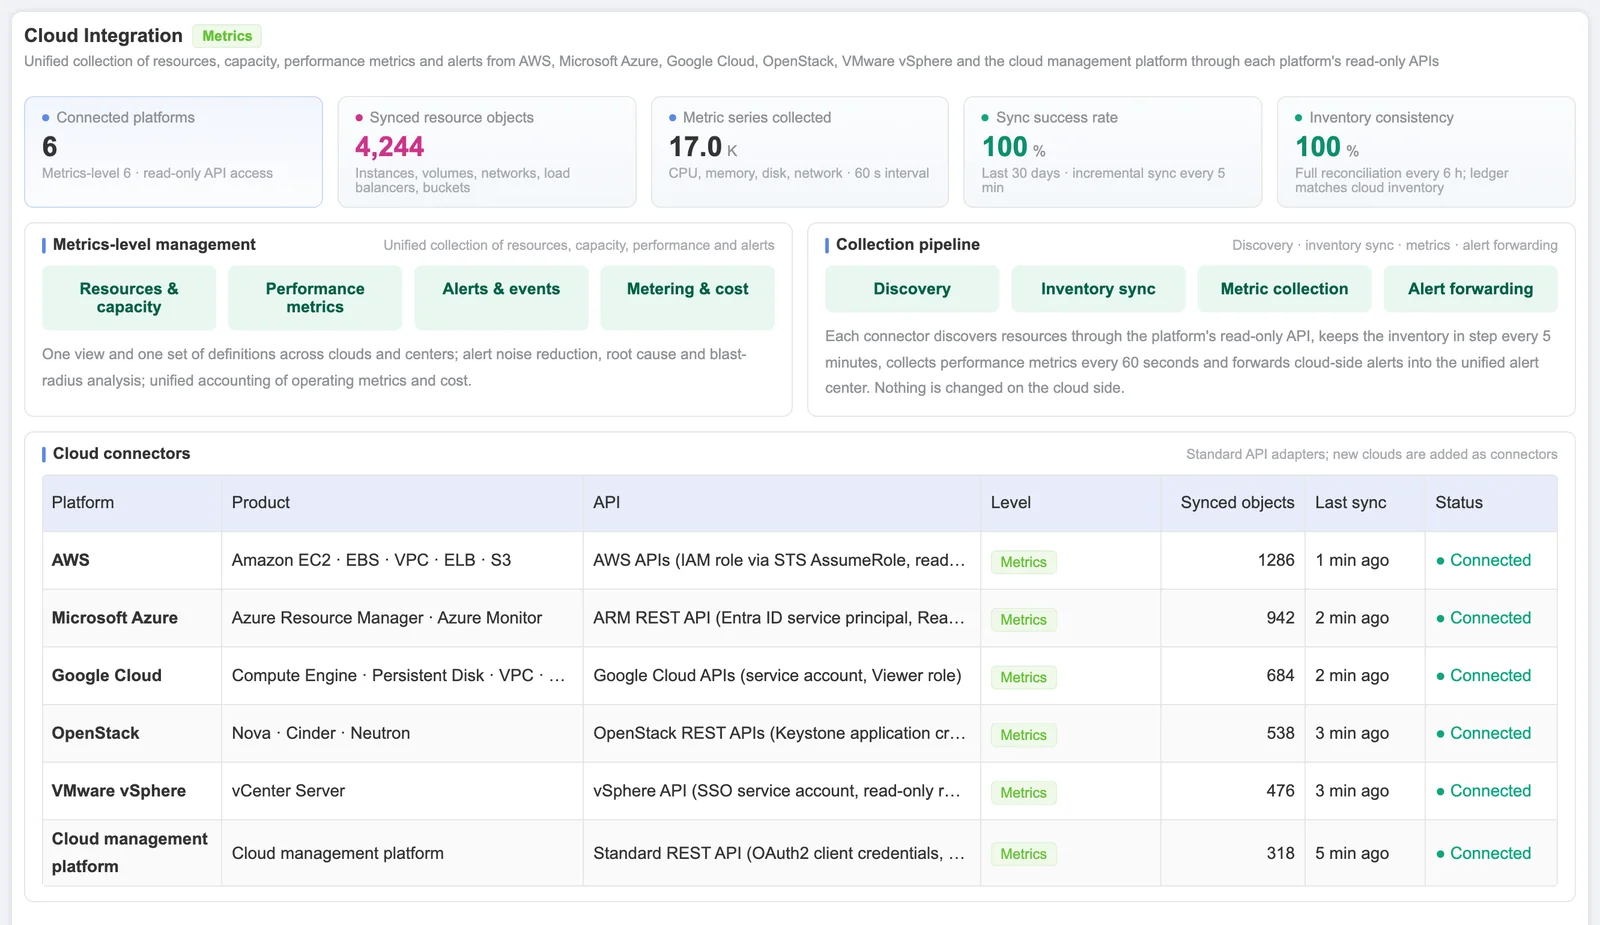
Sensaka erfasst Ressourcen, Kapazität, Performance und Alarme aus AWS, Microsoft Azure, Google Cloud, OpenStack und VMware auf Metrikebene, sodass On-Premises-GPU-Cluster und Cloud-Kapazität nach denselben Definitionen gezählt werden. Änderungen an Cloud-Ressourcen bleiben in den eigenen Tools der jeweiligen Cloud.
Northbound synchronisiert die Plattform CMDB-Datensätze und Tickets mit ServiceNow oder Jira, leitet korrelierte Alarme an PagerDuty, OpsGenie, Slack, E-Mail oder einen Webhook weiter und bietet eine REST API sowie Webhooks für Ihre eigenen Systeme.
Kernfunktionen
- Erfassung auf Metrikebene aus AWS, Azure, GCP, OpenStack und VMware
- CMDB- und Ticket-Synchronisierung mit ServiceNow oder Jira
- Anreicherung der CMDB mit Hardware-Fakten aus dem BMC
- Alarm-Routing an PagerDuty, OpsGenie, Slack, E-Mail oder Webhook
- REST API und Webhooks
- In-Band- und Out-of-Band-Erfassung über 14 Protokolle
Aufgebaut auf den DCIM-, ITSM- und AIOps-Ebenen von Sensaka
Die KI-Plattform ist keine eigenständige neue Codebasis. Sie läuft auf denselben Modulen wie Sensaka for Data Centers, dem Produkt für konventionelle Rechenzentren. Die zugrunde liegende Plattform ist seit 9+ Jahren im Produktiveinsatz und überwacht über ihre Installationsbasis hinweg 3M+ Geräte.
Vom Infrastruktur-Monitoring zum geschlossenen Betriebskreislauf
Sensaka for AI Data Centers verbindet Ressourcen-Discovery, Geräte-Onboarding, Ressourcen-Pooling, Workload-Anfragen, intelligentes Scheduling, Metering, Analysen und Betriebsoptimierung. Mit betrieblichen Erkenntnissen lassen sich Ressourcenspezifikationen, Scheduling-Richtlinien, Quoten und der Management-Umfang anpassen, sodass ein kontinuierlicher Optimierungskreislauf entsteht.
Ressourcenbereitschaft
Geräte automatisch erkennen, heterogene Compute-Ressourcen verwalten und standardisierte Ressourcen-Pools und Spezifikationen aufbauen.
Workload-Bereitstellung
Compute-Ressourcen über Queues, Projektquoten und Scheduling-Richtlinien an Trainings-, Inferenz- und Entwicklungs-Workloads zuweisen.
Betriebsoptimierung
Ressourcenzuweisung und Betriebsrichtlinien fortlaufend optimieren – auf Basis von Auslastung, Workload-Status, Compute-, Netzwerk- und Storage-Performance, Hardwarezustand und Kostendaten.
Entwickelt für jede AI-Infrastruktur-Umgebung
Enterprise-AI-Rechenzentren
Verwalten Sie GPU-Server, Netzwerke, Storage, Flüssigkeitskühlungsinfrastruktur und Workload-Scheduling in einer Plattform, um die interne Ressourcennutzung zu verbessern.
Öffentliche Compute-Zentren
Bauen Sie Multi-Tenant-Ressourcen-Pools, Projektquoten, Workload-Queues und Nutzungsberichte auf, um Ressourcenbereitstellung und kommerziellen Betrieb zu verbessern.
Finanzdienstleistungen und Branchen mit hohen Verfügbarkeitsanforderungen
Nutzen Sie In-Band- und Out-of-Band-Erfassung, Monitoring auf Komponentenebene, Ausfall-Impact-Analysen und auditierbare Betriebsprozesse, um kritische Trainings- und Inferenzdienste zu schützen.
Telekommunikation und Multi-Site-Umgebungen
Verwalten Sie regionale Rechenzentren, verteilte Cluster, Infrastrukturressourcen und Betriebsdaten standortübergreifend zentral.
Universitäten und Forschungseinrichtungen
Verwalten Sie GPU-Anfragen, Quoten, Zuweisung, Nutzung und Ressourcenfreigabe über Forschungsteams, Abteilungen und Projekte hinweg.
Was sich ändert, wenn jeder Beschleuniger verwaltet wird
Vollständige Compute-Transparenz gewinnen
Sehen Sie GPUs, NPUs, Server, Netzwerke, Storage, Flüssigkeitskühlungsanlagen und Rack-Ressourcen über eine Plattform.
Ressourcennutzung verbessern
Reduzieren Sie Compute-Verschwendung durch Ressourcen-Pooling, Spezifikationsmanagement, Workload-Scheduling und die Identifikation ungenutzter Ressourcen.
Problemlösung beschleunigen
Nutzen Sie GPU- und Container-Korrelation zusammen mit Compute-, Netzwerk- und Storage-Analysen, um Engpässe und Business-Auswirkungen schneller zu erkennen.
Stabilität von Training und Inferenz schützen
Erkennen Sie Hardware-, Netzwerk-, Storage-, Temperatur- und Flüssigkeitskühlungsrisiken, bevor sie Workloads unterbrechen.
Eine verlässliche Betriebsdatengrundlage aufbauen
Verbinden Sie Ressourcen, Workloads, Projekte, Mitarbeitende, Kosten und Business Services, um Betriebs- und Managemententscheidungen zu unterstützen.
Sensaka AI-Infrastruktur-Lösungen entdecken
Häufig gestellte Fragen
Was ist KI-Infrastrukturmanagement?
KI-Infrastrukturmanagement bedeutet, ein KI-Rechenzentrum oder eine KI-Fabrik produktiv zu halten: zu wissen, wo sich jeder Beschleuniger befindet und in welchem Zustand er ist, GPU-Kapazität fair zuzuweisen, Jobs zu verfolgen, Stromversorgung und Kühlung im Blick zu behalten und GPU-Stunden sowie Tokens abzurechnen. Sensaka erledigt dies auf einer Plattform mit einem Inventar.
Nutzt das AI Cockpit ein externes KI-Modell?
Nein. Das AI Cockpit gleicht Fragen lokal mit vordefinierten Betriebsfragen ab und erstellt Board und Video aus Daten, die bereits in der Plattform vorliegen. Es läuft On-Premises, und Ihre Daten verlassen das Rechenzentrum nicht.
Welche Beschleuniger unterstützt die Plattform?
NVIDIA, AMD und andere Beschleuniger. Unterstützte Modelle und Felder hängen von den Management-Schnittstellen des jeweiligen Herstellers ab und werden für Ihre Hardware im Scoping-Gespräch vor einem Pilot bestätigt.
Ist Sensaka eine GPU-Monitoring-Software oder ein Scheduler?
Es ist eine GPU-Monitoring-Software und eine Betriebsplattform, die mit Ihren Schedulern zusammenarbeitet. Sensaka liest Jobs aus Slurm und Kubernetes aus, verwaltet Pools, Spezifikationen und Quoten und überwacht die darunterliegende Hardware und Facility; den von Ihnen eingesetzten Scheduler ersetzt es nicht.
Wie fangen wir an?
Mit einem kostenlosen 30-tägigen On-Premises-Pilot auf einem Teil Ihrer Umgebung, mit Erfolgskriterien, die vor dem Start vereinbart werden. Öffentliche Listenpreise für die DCIM- und Monitoring-Ebenen der Plattform finden Sie auf der Preisseite; Partner, die Sensaka weiterverkaufen oder integrieren, erhalten im ersten Jahr eine Marge von 25%.
Jeden Beschleuniger sichtbar, verwaltbar, planbar und messbar machen
Sensaka for AI Data Centers hilft Organisationen, KI-Infrastruktur und heterogene Compute-Ressourcen in einer einheitlichen Umgebung zu verwalten. Es schafft einen vollständigen Betriebskreislauf vom Geräte-Monitoring und GPU-Ressourcen-Scheduling über die Koordination von Compute, Netzwerk und Storage, das Flüssigkeitskühlungs-Monitoring und die CMDB bis hin zu Metering und Betriebsoptimierung.
Der Pilot läuft 30 Tage lang On-Premises und kostenlos, mit Erfolgskriterien, die vor dem Start vereinbart werden.
Integratoren und Reseller: Das Sensaka-Partnerprogramm bietet im ersten Jahr eine Marge von 25%. Sprechen Sie uns an.