Monitoring infrastruktury GPU dla centrów danych AI
Dla zespołów platformowych i infrastrukturalnych zarządzających klastrami GPU pojedyncza przegrzewająca się obudowa lub uszkodzony zasilacz mogą zatrzymać rozproszone zadanie treningowe i zmarnować godziny kosztownej mocy obliczeniowej. Monitoring infrastruktury GPU śledzi kondycję akceleratorów, temperaturę obudów, integralność zasilania i awarie pamięci na poziomie sprzętu, dzięki czemu awarie węzłów są wykrywane jako zdarzenia sprzętowe, a nie tajemniczo znikające węzły.
Sensaka for Data Centers zbiera tę telemetrię w sposób bezagentowy przez BMC, niezależnie od systemu operacyjnego, w serwerach i obudowach GPU różnych producentów. Moduł AIOps Sensaka łączy następnie każdy węzeł z zadaniami i usługami, które od niego zależą, dzięki czemu zespoły reagują na podstawie wpływu, a nie surowego alarmu.
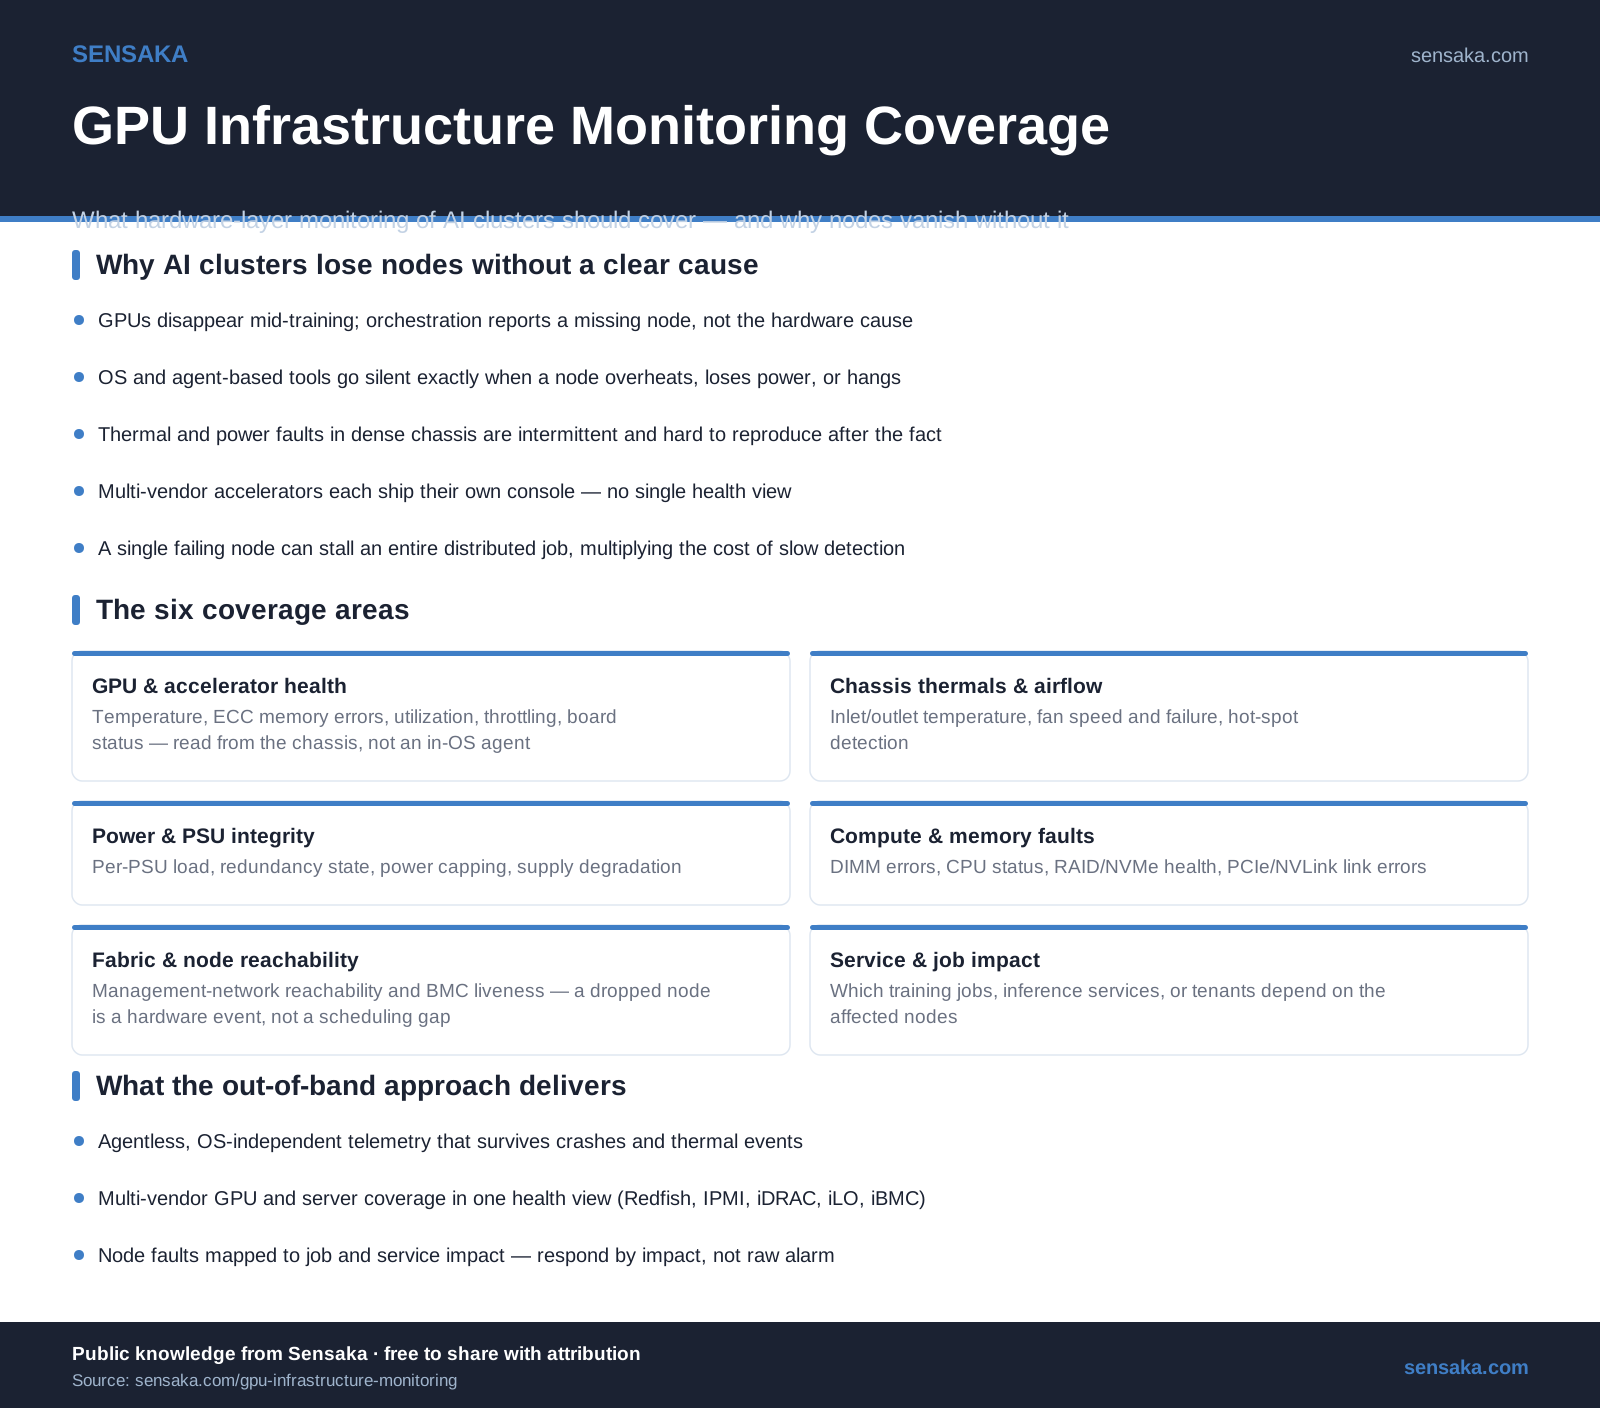
Dlaczego klastry AI tracą węzły bez jasnej przyczyny
Narzędzia orkiestracji i obserwowalności widzą objaw — węzeł, który wypadł z klastra — ale rzadko przyczynę fizyczną. W gęstych środowiskach GPU przyczyna zwykle leży poniżej systemu operacyjnego: w cieple, zasilaniu, pamięci lub awarii łącza.
Co powinien obejmować monitoring infrastruktury GPU
Kondycja GPU i akceleratorów
Temperatura GPU, błędy pamięci ECC, wykorzystanie, throttling oraz stan na poziomie płyty w akceleratorach NVIDIA i innych, odczytywane bezpośrednio z obudowy, a nie za pomocą zawodnego agenta działającego wewnątrz systemu operacyjnego.
Temperatura i przepływ powietrza w obudowie
Temperatura wlotowa i wylotowa, prędkość obrotowa wentylatorów oraz ich awarie, a także wykrywanie punktów przegrzania w gęstych obudowach GPU, gdzie pojedyncza awaria przepływu powietrza może zdławić cały przebieg treningu.
Integralność zasilania i zasilaczy
Obciążenie poszczególnych zasilaczy, stan redundancji, ograniczanie poboru mocy i degradacja zasilania. Węzły GPU pobierają prąd gwałtownie i w dużych ilościach, dlatego niestabilność zasilania jest jedną z głównych przyczyn cichych awarii węzłów.
Awarie obliczeniowe i pamięci
Błędy DIMM możliwe i niemożliwe do skorygowania, stan CPU, kondycja RAID i NVMe oraz błędy łączy PCIe/NVLink, które objawiają się jako niewyjaśnione awarie zadań na wyższym poziomie.
Dostępność sieci szkieletowej i węzłów
Dostępność sieci zarządzającej oraz aktywność BMC, dzięki czemu węzeł, który wypadł z klastra, zostaje rozpoznany jako zdarzenie sprzętowe, a nie tylko luka w szeregowaniu.
Wpływ na usługi i zadania
Które zadania treningowe, usługi wnioskowania lub dzierżawcy zależą od dotkniętych węzłów, dzięki czemu alert jest powiązany z wpływem na biznes i obciążenia, a nie tylko z identyfikatorem urządzenia.
Od obudowy GPU do usługi biznesowej
Sensaka obsługuje warstwę fizyczną. Odczytuje telemetrię GPU i obudów w sposób bezagentowy przez interfejsy BMC, takie jak Redfish, IPMI, iDRAC, iLO i iBMC, dzięki czemu widoczność jest zachowana nawet w razie awarii systemu operacyjnego, zdarzenia termicznego lub awarii zasilania. Ponieważ jest neutralna względem producentów, serwery GPU różnych marek raportują do jednego widoku kondycji zamiast do osobnych konsol.
Moduł CMDB i ITSM Sensaka ujednolica tę telemetrię sprzętową z danymi logicznymi i operacyjnymi w całym środowisku, a moduł AIOps dodaje mapowanie zależności usług. Dzięki temu uszkodzony węzeł lub obudowa zostają powiązane z działającymi na nich zadaniami treningowymi, usługami wnioskowania i dzierżawcami.
W infrastrukturze AI typowym zestawieniem jest monitoring sprzętu wraz z modułem AIOps: dogłębna widoczność sprzętu na poziomie obudowy, uzupełniona o wpływ na biznes i obciążenia.
Powiązane: monitoring BMC wielu producentów, monitoring out-of-band, monitoring sprzętu wielu producentów oraz monitoring temperatury serwerów.
Źródła: NVIDIA Data Center GPU Manager (DCGM) oraz standard Redfish (DMTF).
Najczęstsze pytania o monitoring infrastruktury GPU
Free download
GPU Infrastructure Monitoring Coverage
The key facts from this page as one infographic and a printable PDF. Public knowledge: free to share and reuse with attribution to sensaka.com.